
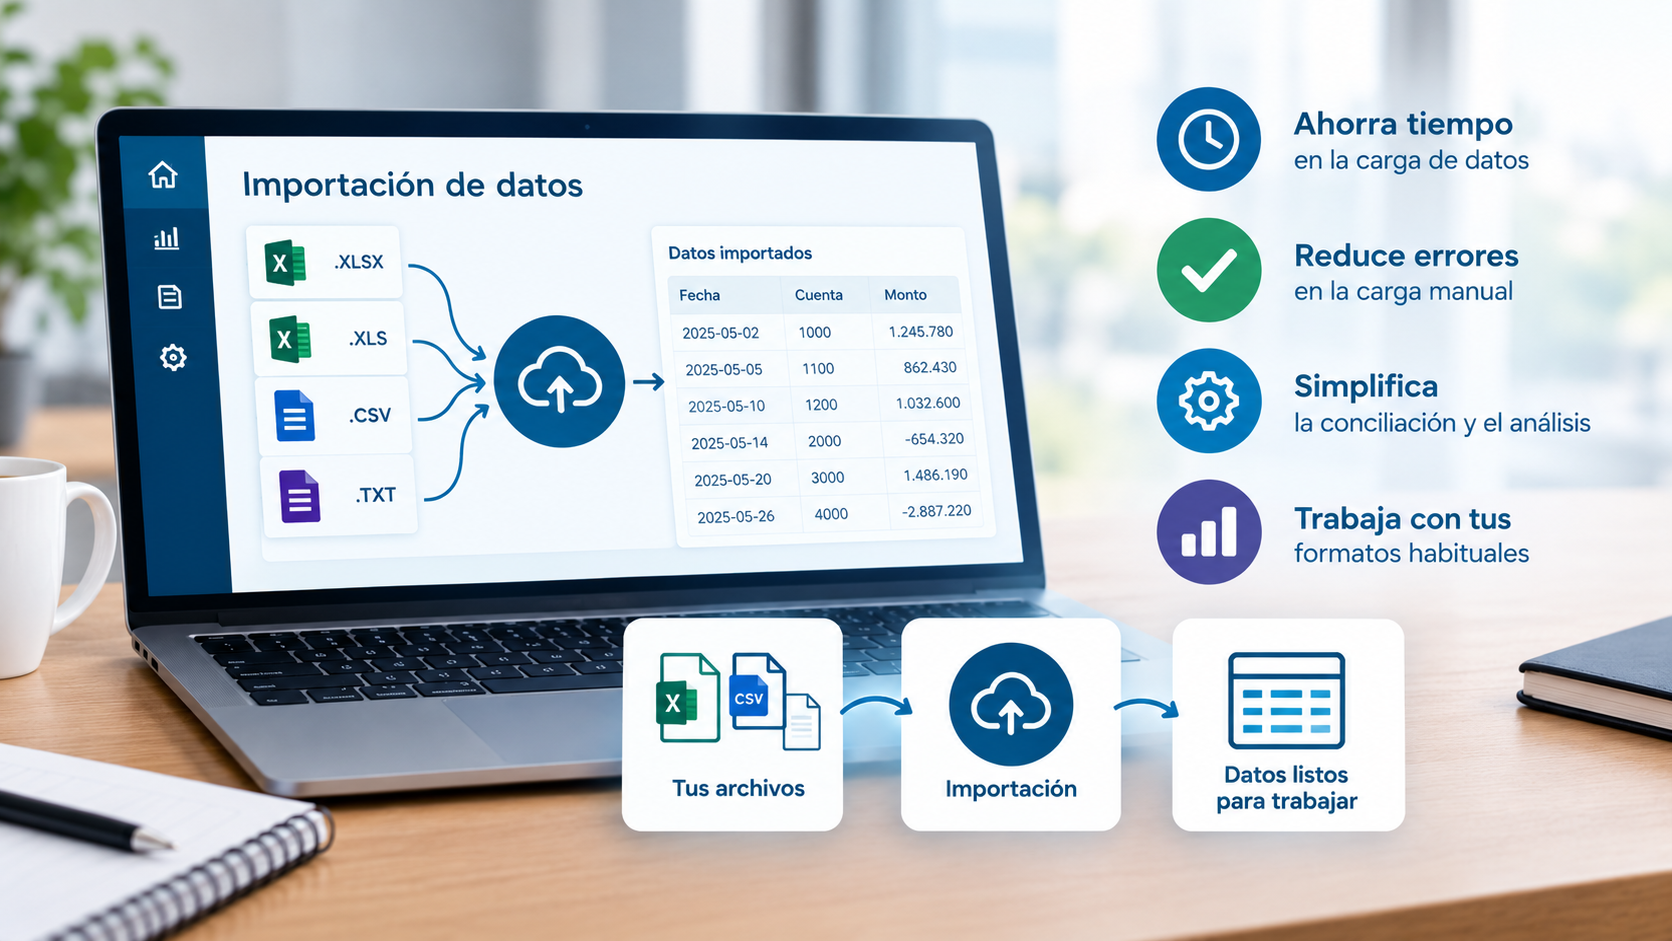
Dado que IDEA no es una herramienta de minería de datos, primero es necesario incorporar los datos desde fuentes externas.
Una de las principales fortalezas de IDEA es su capacidad para importar datos fácilmente desde una amplia variedad de formatos de archivo. Entre ellos se incluyen Microsoft Excel, Microsoft Access, archivos de texto, archivos CSV (valores separados por comas), informes impresos, archivos PDF generados por sistemas y archivos de bases de datos abiertas.
Aspectos a tener en cuenta:
Al importar datos desde Excel:
- Es necesario identificar qué fila contiene los nombres de los campos y a partir de qué fila comienzan los datos propiamente dichos. Este paso es fundamental para garantizar que los datos se importen correctamente al entorno de IDEA, con títulos de campos precisos y sin filas en blanco. El Import Assistant también ofrece una función de vista previa para ingresar estos datos, lo que evita tener que abrir el archivo por separado para verificar su estructura.
- La opción de selección de hojas de Excel permite elegir únicamente aquellas hojas que sean relevantes para el análisis. Es posible seleccionar varias hojas e IDEA importará todas las hojas de trabajo seleccionadas en un único proceso.
- Por último, el archivo de Excel no debe estar protegido con contraseña.
Al importar datos desde Microsoft Access:
- Si la base de datos contiene más de una tabla, IDEA permite importar varias tablas al mismo tiempo seleccionando las casillas correspondientes durante la etapa Select Table.
- Es importante tener en cuenta que cualquier configuración seleccionada en Character Field Options se aplicará de manera uniforme a todas las tablas que se importen.
Al importar datos desde texto semiestructurado (CSV/DEL):
- El Import Assistant de IDEA primero analiza el archivo seleccionado para determinar si se trata de un archivo delimitado o de longitud fija. En función de esta evaluación, intenta identificar automáticamente la longitud de registro adecuada, haciendo que el proceso de importación sea más eficiente y sencillo para el usuario.
En la etapa Field Separator Defining, es necesario especificar el carácter especial utilizado en el archivo para separar los campos. Este paso es fundamental para garantizar una correcta organización de los datos en columnas.
En esta etapa también se puede definir la cantidad de filas que deben excluirse de la importación. Esto resulta especialmente útil cuando el archivo contiene información que no forma parte de los datos (como el nombre de la empresa, el título del informe u otros encabezados innecesarios).
En la etapa Field Details, se debe ingresar la información necesaria para cada campo, incluido el título de la columna. Este es un paso importante, ya que permite garantizar que los datos importados queden correctamente estructurados y listos para el análisis.
Además, esta etapa permite excluir los campos que no sean relevantes seleccionando la opción “Do not import this field”, lo que permite importar únicamente los datos necesarios.
Comprender estos requisitos básicos de importación es fundamental para garantizar que los datos en IDEA sean limpios, precisos y estén listos para el análisis. Un proceso de importación bien preparado puede ahorrar tiempo, reducir errores y hacer que el análisis general sea mucho más efectivo.
Equipo de Auditech Data